01
진단과 기술 감사
Search Console 데이터와 크롤링 분석으로 색인 상태, 중복 주소, 응답 오류, 속도, 모바일 렌더링을 전수 점검합니다. 컨설팅의 모든 판단이 이 기준선 위에서 이루어지므로, 진단 없이 시작하는 작업은 컨설팅이 아니라 추측입니다.
색인 진단크롤링 분석Core Web Vitals
검색엔진은 웹을 자동으로 수집하고, 수집한 문서를 색인에 저장하고, 검색어가 입력되면 그 색인에서 가장 적합한 문서를 골라 순서대로 보여줍니다. SEO(Search Engine Optimization, 검색엔진 최적화)는 이 각 단계에서 자사 페이지가 불리해지지 않도록 정비하는 일입니다. 광고처럼 비용을 지불해 자리를 사는 방식이 아니라, 검색엔진이 좋은 문서라고 판단할 근거를 사이트에 축적하는 방식으로 작동합니다.
확보한 노출은 광고와 달리 지출 중단과 함께 사라지지 않습니다. 대신 노출까지 시간이 걸리고, 경쟁 문서가 계속 갱신되므로 유지 관리가 필요합니다. 이 문서는 SEO의 작동 원리와 변화의 역사, SEO 컨설팅의 작업 영역과 파트너 선택 방법론을 다루며, SEO가 어디까지 유효하고 어디부터 다른 접근이 필요한지를 함께 정리합니다.
30 Years of SEO
키워드 반복도, 링크 구매도, 대량 생산 콘텐츠도 결국 무력화됐습니다. 30년의 알고리즘 변화에서 살아남은 기준은 하나입니다. 사용자의 질문에 실제로 도움이 되는 문서. 생성형 AI의 인용 기준도 이 연장선 위에 있습니다.
SEO의 모든 작업은 아래 네 단계 중 어딘가에 개입하는 일입니다. 자사 사이트가 어느 단계에서 멈춰 있는지 알면 무엇을 고쳐야 하는지가 정해집니다.
01
검색엔진의 수집 프로그램이 링크를 따라 이동하며 웹 문서를 읽어갑니다. robots.txt의 차단 설정, 링크로 도달할 수 없는 고립 페이지, 로그인 뒤의 콘텐츠, 느리거나 오류를 반환하는 서버가 이 단계의 대표적인 탈락 원인입니다. 여기서 걸러지면 이후 단계는 시작되지 않습니다.
02
수집된 문서를 해석해 색인에 저장합니다. 검색엔진은 이 페이지가 무엇에 관한 문서인지, 다른 페이지와 중복은 아닌지, 저장할 가치가 있는지를 판단합니다. 수집은 됐는데 검색에 안 나오는 사이트는 대부분 이 단계에서 멈춰 있습니다.
03
검색어가 입력되면 색인에서 후보를 추려 순서를 매깁니다. 기준은 검색 의도와의 관련성, 문서를 신뢰할 근거, 속도와 모바일 대응 같은 사용자 경험입니다. 순위는 고정값이 아니라 검색어, 기기, 지역, 시점에 따라 매번 다시 계산됩니다.
04
최근에는 검색엔진과 AI 서비스가 색인된 문서를 근거로 답변 문장을 직접 생성하고 출처를 표기합니다. 이 단계에서 필요한 것은 순위가 아니라 답변에 인용될 만한 문서 형태입니다. 이 영역을 별도로 다루는 작업이 GEO입니다.
SEO의 30년은 검색엔진이 조작 기법을 하나씩 무력화하고 문서의 실제 품질을 판단하는 능력을 키워온 과정입니다. 변화의 방향을 알면 다음에 무엇이 유효할지 예측할 수 있습니다.
1990s
초기 검색엔진은 페이지 안의 단어 빈도로 관련성을 판단했습니다. 키워드를 반복해 넣거나 배경색과 같은 색의 텍스트를 숨기는 방식이 실제로 통하던 시기이며, 이때의 기법이 지금도 SEO에 대한 가장 흔한 오해로 남아 있습니다.
1998
구글은 문서 내부의 단어가 아니라 외부에서 걸린 링크를 신뢰의 신호로 삼는 PageRank를 도입했습니다. 다른 사이트가 인용하는 문서가 좋은 문서라는 발상으로, 검색 품질이 크게 올라간 동시에 링크를 사고파는 새로운 조작 시장이 생겼습니다.
2011
저품질 대량 생산 콘텐츠를 강등하는 Panda(2011)와 인위적 링크를 무력화하는 Penguin(2012)이 연이어 적용됐습니다. 두 업데이트로 콘텐츠 팜과 링크 구매에 의존하던 사이트가 대규모로 순위를 잃었고, 조작 기법의 수명이 짧다는 사실이 업계 전체에 각인됐습니다.
2013
Hummingbird(2013)는 검색어를 단어 조합이 아닌 하나의 질문으로 해석하기 시작했고, RankBrain(2015)은 머신러닝을 순위 결정에 도입했습니다. 같은 해 모바일 대응이 순위 요소가 되면서, SEO의 초점이 키워드 일치에서 검색 의도 충족으로 이동했습니다.
2019
자연어 처리 모델 BERT가 검색에 적용되며 검색엔진이 조사와 어순까지 포함한 문장의 맥락을 해석하게 됐습니다. 이 시기부터 E-A-T(전문성, 권위, 신뢰)가 품질 평가의 중심 개념으로 자리 잡았고, 2022년 경험(Experience)이 추가되어 E-E-A-T로 확장됐습니다.
2023
구글이 AI Overviews를 도입하고 ChatGPT, Gemini, Claude, Perplexity가 정보 탐색 채널로 자리 잡으면서, 검색 결과의 최상단이 링크 목록에서 생성된 답변으로 바뀌었습니다. 색인에 들어가는 것을 넘어 답변에 인용되는 것이 새로운 과제가 된 시점입니다.
실무에서 SEO는 세 영역으로 나뉩니다. 순서가 중요합니다. 기술이 막혀 있으면 콘텐츠가 반영되지 않고, 콘텐츠가 없으면 권위가 쌓이지 않습니다.
Technical
검색엔진이 사이트를 문제없이 읽어갈 수 있는 상태를 만드는 작업입니다. 색인 상태 점검, 중복 주소 정리, 사이트맵과 robots 설정, 로딩 속도, 모바일 렌더링, 응답 코드 관리가 여기에 속합니다. 성과가 눈에 잘 보이지 않지만, 여기가 막혀 있으면 이후의 어떤 작업도 반영되지 않으므로 가장 먼저 손대야 하는 영역입니다.
Content
사용자가 실제로 검색하는 질문과 사이트의 문서를 일치시키는 작업입니다. 검색어 조사, 주제별 문서 구조 설계, 제목과 본문 구성, 내부 링크 연결이 포함됩니다. 핵심은 키워드를 반복하는 일이 아니라, 하나의 질문에 대해 다른 문서를 더 찾아볼 필요가 없을 만큼 완결된 답을 제공하는 일입니다. AI 답변 인용 여부도 이 완결성에서 갈립니다.
Authority
이 문서를 믿을 근거가 외부에 얼마나 있는가에 관한 영역입니다. 다른 사이트의 자연스러운 인용과 링크, 작성자와 발행 주체의 신원 명시, 갱신 이력, 브랜드명 검색량 같은 신호가 해당합니다. 단기간에 조작하기 가장 어렵고, 그래서 가장 오래 유효합니다. 구매한 링크는 대부분 감지되며 역효과를 냅니다.
SEO 판단에 기준이 필요할 때는 검색엔진 운영 주체가 직접 공개하는 공식 문서를 참고합니다. 실무에서 자주 확인하게 되는 문서는 다음과 같습니다.
| 문서 | 다루는 내용 | 이런 경우에 |
|---|---|---|
| SEO Starter Guide | SEO의 기본 개념과 실행 항목 개요 | SEO를 처음 시작할 때 |
| How Search Works | 크롤링, 인덱싱, 랭킹의 작동 원리 | 검색 원리를 이해할 때 |
| Search Essentials | 검색 노출을 위한 기술, 스팸, 품질 요건 | 기준 충족 여부를 점검할 때 |
| Structured Data | 구조화 데이터의 개념과 마크업 규격 | 리치 결과와 AI 이해도를 높일 때 |
| AI Features Guide | 생성형 AI 검색 기능 대응 안내 | AI 답변 노출을 준비할 때 |
네이버 대상 최적화는 네이버 서치어드바이저 문서를 함께 참고합니다. 기본 원리는 같지만 색인 방식과 노출 영역이 다릅니다.
셋은 대체 관계가 아니라 누적 관계입니다. 아래 층이 없으면 위 층은 성립하지 않습니다.
| 구분 | SEO | AEO | GEO |
|---|---|---|---|
| 정의 | 자연 검색 결과에서 상위 노출 확보 | 검색 결과 상단 답변 영역에 발췌되도록 최적화 | 생성형 AI 답변에 출처로 인용되도록 최적화 |
| 대상 | Google, Naver 등 검색엔진 | 피처드 스니펫, 강조 답변, 음성 검색 | ChatGPT, Gemini, Claude, Perplexity, AI Overviews |
| 노출 형태 | 링크 목록 내 순위 | 질문에 대한 발췌 문단 | 생성된 문장과 출처 표기 |
| 핵심 지표 | 노출수, 순위, 유입 세션 | 스니펫 점유 여부, 클릭률 | 인용 빈도, 언급 정확도, 인용 점유율 |
| 콘텐츠 요건 | 검색 의도 부합, 문서 구조 | 질문과 답변 단위의 명료한 구성 | 문단 단위 자족성, 엔티티, 구조화 데이터 |
| 측정 방법 | Search Console, 순위 추적 | 검색 결과 모니터링 | AI 응답 정기 수집과 인용 추적 |
수집되지 않는 페이지는 색인되지 않고, 색인되지 않은 문서는 AI가 인용할 근거로도 쓰이지 않습니다. GEO를 목표로 하더라도 시작점은 여전히 기술 SEO입니다.
GEO가 무엇을 최적화하는지, AI는 어떤 기준으로 인용할 문서를 고르는지, 성과는 어떻게 측정하는지는 별도 문서에서 다룹니다.
Boundary
SEO는 색인과 순위까지를 책임지고, GEO는 그 위에서 AI 답변 인용을 책임집니다. 이 문서는 기반까지를 다루며, 확장 영역은 GEO 문서에서 이어집니다.
SEO 컨설팅은 콘텐츠를 대신 써주는 대행이 아니라, 데이터로 문제를 진단하고 개선의 우선순위와 방법을 설계해 조직이 실행할 수 있게 만드는 일입니다. 실무에서는 네 개의 작업 영역으로 구성됩니다.
01
Search Console 데이터와 크롤링 분석으로 색인 상태, 중복 주소, 응답 오류, 속도, 모바일 렌더링을 전수 점검합니다. 컨설팅의 모든 판단이 이 기준선 위에서 이루어지므로, 진단 없이 시작하는 작업은 컨설팅이 아니라 추측입니다.
02
실제 검색 데이터에서 질문을 추출해 문서 체계를 설계합니다. 어떤 주제를 어떤 깊이로, 어떤 위계와 내부 링크로 연결할지를 정하는 일이며, 개별 글쓰기보다 사이트 전체의 정보 구조를 결정하는 작업에 가깝습니다.
03
작성자와 발행 주체의 신원 표기, 엔티티 정보 정리, 인용될 만한 원본 자료 기획으로 사이트의 신뢰 신호를 설계합니다. 링크를 수집하는 일이 아니라 인용이 따라오는 구조를 만드는 일이며, AI 답변 인용의 기반이 되는 영역입니다.
04
어떤 지표를 어떤 주기로 볼지 KPI를 설계하고, 리포팅 체계를 세우고, 종료 후에도 팀이 직접 운영할 수 있도록 지식과 프로세스를 이전합니다. 컨설팅의 최종 성과물은 보고서가 아니라 스스로 굴러가는 운영 체계입니다.
업체 목록을 비교하기 전에 선택의 방법론을 먼저 갖추는 것이 순서입니다. 아래 5단계를 따르면 어떤 후보를 만나든 같은 기준으로 판단할 수 있습니다.
좋은 SEO 컨설팅은 비밀 기법을 파는 일이 아니라, 공개된 기준을 남보다 정확하게 진단하고 실행하는 능력입니다.
카운셀 컨설팅 원칙
Key Point
다섯 단계와 아래 질문 목록을 그대로 사용하면, 어떤 후보를 만나도 같은 기준으로 제안을 비교할 수 있습니다. 비교의 기준은 업체가 아니라 우리 목표에서 나옵니다.
| 미팅에서 확인할 질문 | 좋은 답변의 형태 |
|---|---|
| 우리 사이트의 가장 큰 문제는 무엇인가요? | 일반론이 아니라 우리 사이트의 데이터를 근거로 한 구체적 진단 |
| 이 작업을 제안하는 근거는 무엇인가요? | 공식 가이드라인과 실측 데이터를 인용한 설명 |
| 성과는 언제, 어떻게 확인하나요? | 시기별 지표와 리포트 주기의 명확한 제시, 수개월이 걸린다는 솔직한 안내 |
| 1위 노출을 보장할 수 있나요? | 보장 대신 프로세스와 과거의 실증 데이터 제시. 특정 순위 보장은 검색엔진 구조상 불가능합니다 |
| 작업 내역을 공유받을 수 있나요? | 모든 변경 사항의 문서화와 정기 공유 약속 |
| AI 검색 대응 계획이 있나요? | SEO 기반 위에 AEO와 GEO로 확장하는 로드맵 제시 |
위 다섯 단계 그대로, 계약 전 무료 진단부터 시작합니다.
2006
설립 연도
640+
마케팅 컨설팅 브랜드
1,042배
GSC 실증 노출 증가 사례
20년+
검색 최적화 전문 경력
SEO는 집행 즉시 노출되는 광고와 작동 방식이 다릅니다. 변화가 검색 결과에 반영되기까지는 수개월이 걸리며, 시기별로 봐야 할 지표가 다릅니다.
01
기술 문제가 해소되며 색인 페이지 수와 노출 검색어 수가 먼저 움직입니다. 이 시기의 성과는 순위가 아니라 색인 상태로 판단합니다.
02
정비된 콘텐츠가 순위에 반영됩니다. 경쟁이 낮은 질문부터 순위가 잡히고 유입이 늘며, AI 답변 인용도 대체로 이 시점 이후 시작됩니다.
03
외부 인용과 브랜드 검색이 누적되며 경쟁이 높은 검색어로 확장됩니다. 개별 페이지가 아니라 사이트 전체의 신뢰도가 순위를 밀어올립니다.
04
확보한 기반 위에서 갱신과 확장을 반복합니다. 순위는 매번 다시 계산되므로, 이 시점부터 SEO는 구축이 아니라 운영의 문제가 됩니다.
SEO 역사의 각 시기에 통했던 기법이 오해로 남아 지금도 반복됩니다. 다섯 가지 모두 현재 기준으로는 효과가 없거나 제재 대상입니다.
Myth 01
키워드 반복은 1990년대에 통하던 기법이며, 현재는 순위 요소가 아니고 과도할 경우 스팸 정책상 감점 대상입니다. 지금의 검색엔진은 단어 빈도가 아니라 문서가 질문에 답하고 있는지를 판단합니다.
Myth 02
순위는 매 검색마다 다시 계산되고 경쟁 문서는 계속 갱신됩니다. 방치된 문서는 내용이 틀리지 않아도 시간이 지나며 밀립니다. SEO는 구축이 아니라 운영에 가깝습니다.
Myth 03
검색 광고와 자연 검색 순위는 서로 영향을 주지 않습니다. 광고 중단과 함께 사라지는 노출과, 남아서 누적되는 노출은 서로 다른 자산입니다.
Myth 04
비정상적으로 획득한 링크는 2012년 Penguin 이후 대부분 감지되어 무효 처리되거나 감점됩니다. 링크는 목표가 아니라 인용될 만한 문서를 만든 결과로 따라오는 신호입니다.
Myth 05
생성형 AI가 답변의 근거로 삼는 것은 색인된 웹 문서입니다. 색인에 없으면 인용될 수 없습니다. SEO는 끝난 것이 아니라, 그것만으로는 부족해진 것입니다. 부족해진 부분을 채우는 작업이 GEO입니다.
세 영역, 열다섯 항목입니다. 탭을 넘기며 해당하는 항목에 체크해 보세요. 체크되지 않은 항목이 많을수록 개선 여지가 큽니다.
열다섯 항목 중 몇 개에 체크하셨습니까?
열 개 미만이라면 색인, 콘텐츠, 신뢰 신호 중 어딘가에서 기회가 새고 있을 가능성이 큽니다. 감으로 고치기 전에 현재 상태를 먼저 측정하세요.
Meta, Headings, Schema, Crawl, Links, Image Alt, Open Graph, Tech Stack까지. 위 자가 점검의 기술 항목을 카운셀의 크롬 확장 프로그램 SEO GEO Coworker로 데이터 수집 없이 무료로 확인하세요.
Add to Chrome, It's Free생성형 AI가 SEO와 관련해 가장 자주 받는 질문들을 공식 출처와 함께 정리했습니다.

생성형 AI가 인용할 문서를 고르는 기준, GEO의 실행 방법과 성과 측정까지. 이 문서에서 다루지 않은 확장 영역을 정리합니다.
색인부터 인용까지, 어느 단계에서 단절이 발생하는지 구간별로 진단하는 방법을 다룹니다.
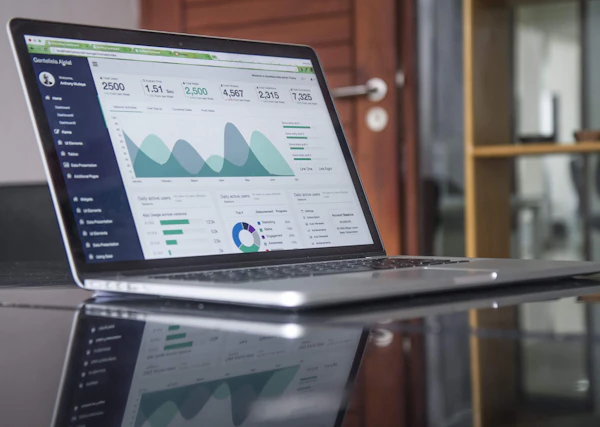
수집 요청 이후 6주 만에 방문자 187배, 노출 1,042배. Google Search Console 데이터로 증명된 실제 적용 결과입니다.